Posts

Showing posts with the label OCR

Textboxes: A fast text detector with a single deep neural network (AAAI 2017)

Image
논문제목: Textboxes: A fast text detector with a single deep neural network 주저자:  Liao, M. ( Huazhong University of Science and Technology) 본 연구의 주요 기여는 text detection 에 적합한 anchor box architecture 를 제시했다는 것에 있다. 일반적인 object detection 의 anchor box 는 정사각형 형태를 기준으로 가로, 세로 방향으로 각각 조금씩 더 긴 anchor box set 에 기반하여 이미지 내의 object 와 가장 가까운 anchor box 를 할당하는 구조이다. 그러나, text line 의 경우  가로-세로 비율이  사람, 개, 자동차 등과 같은 일반적인 객체와는 조금 다르다. 즉, text line 은 대체로 가로 방향으로 매우 긴 특징이 있다. 이를 위해서 본 연구에서는 anchor box 를 세로 방향으로는 매우 짧고, 가로 방향으로는 매우 긴 형태의 anchor box set 을 제안하고 있다. 이 경우, 정사각형의 중심 기준으로만 anchor box 를 설정하게 되면, 아래 위로 인접한 두 개의 정사각형 anchor box 접점 위치에서는 가로 방향으로 긴 anchor box 가 설정되지 못한다 (아래 figure 2 참조). 본 연구에서 적용한 CNN 구조에 대한 설명은 아래와 같다. VGG-16, SSD 구조를 이용한 word-based OCR approach Multiple feature map 을 활용하는 text-box layer 추가 (아래 그림 참조) Fully convolutional network (only convolutional and pooling layers) Text-box layer -> classification score와 box offset 동시 추정 학습 시 SSD 와 동일한 방식으로 grou...
Recurrent models of visual attention (NIPS 2014)

Image
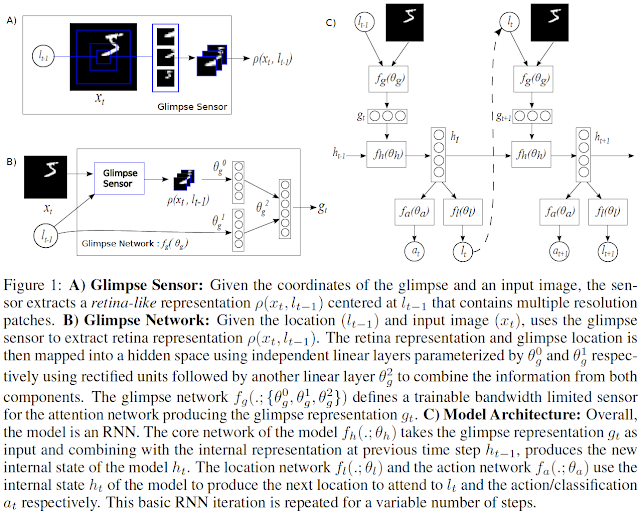
논문 제목: Recurrent models of visual attention. In Advances in neural information processing systems 주 저자:  Volodymyr Mnih (구글 딥마인드) 연구 기관: 구글 딥마인드 일반적으로 CNN (Convolutional Neural Network) 은 이미지 내의 모든 영역에 대해 convolution kernel, pooling, non-linear activation function, normalization 등을 계층적으로 적용하여 최종 feature map 을 생성한 후, 최종 feature map 에 대해 classification, detection, segmentation 등을 적용한다. 이 경우, 분석해야 할 영역 이 외의 나머지 모든 영역들에 대해서도 CNN 을 적용함으로써 과다한 연산량이 소모될 뿐 아니라, 중요한 정보가 있는 영역 외의 정보들이 최종 레이어로 전달되므로 분석에 있어 일종의 'noise' 요인이 될 수 있다. 본 연구는 attention model 을 단문자 인식에 적용한 것으로써, 문자 라인을 형성하는 주요 영역들을 순차적으로 찾아내고, 주요 영역에 국한되는 'local CNN' 을 적용하는 기술이다. 이렇게 함으로써 배경 영역에 대한 분석을 제거하여 불필요한 연산량을 과도하게 소모하지 않고, 주요 영역에 집중하여 분석을 수행할 수 있게 한다. 이러한 처리 과정은 인간이 이미지 내의 객체를 바라볼 때, 배경에 신경쓰지 않고 보고자 하는 객체 영역의 여러 국지적 모양을 훑어보는 것을 모방한 것이다.   기술 구조는 크게 세 가지로 구성된다.  Glimpse Sensor 이전 시점의 location 정보 (l t-1 ) 및 이미지를 입력받아서 그 위치에 해당하는 'local' image patch ⍴(x t , l t-1 ) 생성 (아래 그림의 A) Glim...

Multiple object recognition with visual attention (arXiv 2014)

Image
논문 제목: Multiple object recognition with visual attention 주 저자: Jimmy Lei Ba (토론토 대학) 참여 연구 기관: 토론토 대학, 구글 딥마인드 본 연구는 아래 논문의 후속 연구로써, attention + RNN 구조를 문자열 인식에 적용한 기술이다. 아래 사전 연구 논문에 대한 간단한 리뷰는  여기를 클릭하면  볼 수 있다. 본 연구의 사전 연구 논문 Mnih, V., Heess, N., & Graves, A. (2014). Recurrent models of visual attention. In Advances in neural information processing systems (pp. 2204-2212). [ Network Architecture ] 사전 연구와 유사하게 본 연구는 이미지 내에서  문자 라인을 형성하는 주요 국지 영역들을  순차적으로 찾아내고, 주요 영역에만 국한되는 'local CNN' 을 적용하는 기술이다. 이렇게 함으로써 배경 영역에 대한 분석을 제거하여 불필요한 연산량을 과도하게 소모하지 않고, 주요 영역에 집중하여 분석을 수행할 수 있게 한다. 이러한 처리 과정은 인간이 이미지 내의 객체를 바라볼 때, 배경에 신경쓰지 않고 보고자 하는 객체 영역의 여러 국지적 모양을 훑어보는 것을 모방한 것이다.   본 연구에서 제안하는 기술 구조는 아래 그림과 같다. 아래 그림에서 'context', 'emission', 'glimpse', 'classification' 이 쓰여진 곳에는 각각의 목적에 맞는 neural network 이 위치하고 있다. 위 그림에서 나타나듯이 본 연구에서 제안하는 기술은 context, emission, glimpse, classification 및 recurrent network 으로 구성된다. 사전 연구에서 제안한 기술 구...

Wetext: Scene text detection under weak supervision (ECCV 2017)

Image
논문 제목: Wetext: Scene text detection under weak supervision 연구 기관: Infocomm, Nanyang Technological Univ., National Univ. of Singapore 본 연구는 문자 인식 시, 학습 데이터가 부족할 경우 semi-supervised or weakly supervised learning 을 통해 인식 성능을 향상시킬 수 있음을 보여주는 기술에 관한 것이다 (어찌보면 굳이 테스트 해보지 않아도 당연히 성능이 올라갈 것으로 유추할 수 있어 보인다. 물론 성능 향상 폭이 어느 정도인지는 해 봐야 알 수 있겠지만...). 문자 인식은 크게 2 가지 방식의 기술이 존재한다. 첫째는, 본 연구에서 채용한 것과 같이 단위 문자 (character) 를 검출한 후, 이들의 조합으로 단어 (text line 또는 word) 를 생성하는 방식이다. 둘째는, 단어를 한번에 검출하고 인식하는 방식이다. 본 연구는 첫번째 방법의 인식 기술을 채택하여 실험하였다.  문자열 검출 기술 단위 문자 검출 (Character detection and recognition) 1 stage object detection 기술인 SSD (Single Shot multibox Detecto) 를 채용하여 단위 문자 검출 Backbone 은 VGG-16 구조를 채용하고, 마지막 fully connected layer 는 additional conv. layer 로 대체 Base feature + additional feature 적용 (-> multi-scale feature) 각 feature point 에서 6 개 값을 추정 (bounding box 4 offsets + 2 text/background scores)  Inferencing stage 에서 NMS (Non-Maximum Suppression) 적용 (1,000 개...

EAST: an efficient and accurate scene text detector (CVPR 2017)

Image
논문 제목: EAST: An Efficient and Accurate Scene Text Detector 연구 기관: Megvii Word box detection 의 정확성을 높이는 기술에 촛점을 맞춘 연구 논문이다 (인식 기술 자체는 본 논문의 연구 대상이 아니다). 저자는 지금까지의 word box detection 은 많은 프로세스 단계를 거쳐야 하므로, error propagation 문제가 있음을 지적하고 있다 (아래 그림에서 다른 기술들과 본 기술의 프로세스 구조를 비교하고 있다). 본 연구에서는 3 단계 프로세스 만으로 가장 우수한 multi-oriented word box detection 성능을 확보하였다고 주장하고 있다 (아래 그림 (e) 가 저자가 제안하는 기술 구조이다). Multi-oriented word box detection 은 문자열이 가로 방향이 아닌, 임의 방향으로 존재하여도 문제없이 검출하는 것을 의미한다 (가로 방향만 검출하는 것은 horizontal box detection 이다). [ Data Annotation ] Word 를 둘러싸는 임의 형태 사각형의 꼭지점 (직사각형 아님, 아래 그림 (a), 노란색 점선은 word 크기에 딱 맞는 사각형이며, 녹색 실선은 margin 을 두어 크기를 줄인 사각형), 임의 형태 사각형의 안쪽 영역을 나타내는 text score map (일종의 heat map, 아래 그림 (b)), 임의 형태 사각형을 둘러싸는 가장 작은 크기의 직사각형 (아래 그림 (c) 의 분홍색 선), heat map 영역 내의 각 포인트에서 직사각형 4변 까지의 거리 (아래 그림 (d)), 직사각형이 기울어진 각도 (아래 그림 (e)) 를 ground truth annotation 정보로 만들고 이를 추정한다. 임의 형태 사각형 정보는 word 크기에 딱 맞는 사각형 (아래 그림 (a) 노란색 점선) 및 margin 을 두고 축소시킨 사각형 (아래 그림 (a) 초록색 실선) 정보가 존...